
如何用Pythonic方式基于numpy数组计算泊松分布对数似然累积和

2026-10-1
泊松分布对数似然的Pythonic实现方案
你可以通过NumPy向量化运算或者Python内置生成器表达式实现一行完成求和,不仅写法更简洁,性能也远高于原生循环。
方案1:纯Python无额外依赖实现
如果不需要处理大规模数据,直接用sum加生成器表达式即可完全复现原有逻辑:
from math import log, factorial

def LogLikelihood(arrival_times, _lambda):
    """Calculate the likelihood that _lambda predicts the arrival_times well."""
    return sum(-_lambda + t * log(_lambda) - log(factorial(t)) for t in arrival_times)
方案2:NumPy向量化实现(推荐处理大规模数据)
利用NumPy的数组广播特性替代显式循环,运算效率比Python循环高1-2个数量级,适合数据量较大的场景:
import numpy as np

def LogLikelihood(arrival_times, _lambda):
    """Calculate the likelihood that _lambda predicts the arrival_times well."""
    return np.sum(-_lambda + arrival_times * np.log(_lambda) - np.log(np.vectorize(factorial)(arrival_times)))
方案3:数值稳定的生产级实现
上述两种方案在t值较大时会出现阶乘溢出问题,推荐用scipy.special.gammaln替代阶乘取对数的操作(数学上ln(n!) = gammaln(n+1)),既避免溢出又进一步提升性能:
import numpy as np
from scipy.special import gammaln

def LogLikelihood(arrival_times, _lambda):
    """Calculate the likelihood that _lambda predicts the arrival_times well."""
    return np.sum(-_lambda + arrival_times * np.log(_lambda) - gammaln(arrival_times + 1))
原问题对应的泊松分布对数似然公式如下: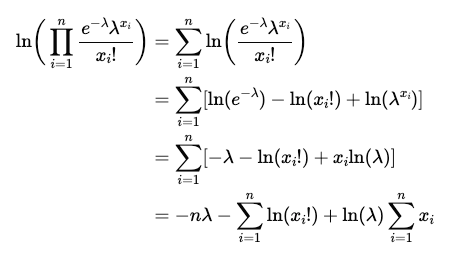
内容的提问来源于stack exchange,提问作者Ricky Palaguachi
相关产品推荐
相关产品推荐


