
如何简化PyTorch中基于einsum的多张量求和运算实现

2026-9-23
PyTorch einsum 求和运算优化方案
原始实现说明
给出的原始PyTorch代码如下:
X = torch.einsum("rij, sij -> rs", A, A)
Y = torch.einsum("rij, sij -> rs", B, B)
Z = torch.einsum("rij, sij -> rs", C, C)
torch.einsum("ij, ij, ij -> ", X, Y, Z)
其对应的数学运算为:
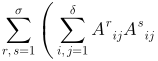%5Cleft(%5Csum_%7Bk,l=1%7D%5E%5Cdelta&space;B%5Er_%7Bkl%7DB%5Es_%7Bkl%7D&space;%5Cright&space;)%5Cleft(%5Csum_%7Bm,n=1%7D%5E%5Cdelta&space;C%5Er_%7Bmn%7DC%5Es_%7Bmn%7D&space;%5Cright&space;)
已知X、Y、Z均为对称矩阵,完全可以改写为更简洁、性能更高的形式,以下是不同层级的优化方案:
优化方案
1. 合并einsum运算(最简洁写法)
将四步einsum合并为单个表达式,避免显式生成X、Y、Z三个中间大矩阵,减少内存开销和核函数启动次数:
res = torch.einsum("rij,sij,rkl,skl,rmn,smn->", A, A, B, B, C, C)
该写法和原始逻辑完全等价,PyTorch内置的einsum优化器会自动规划最优计算路径,不需要人工干预。
2. 矩阵乘法替换(性能最优写法)
对于大规模张量运算,cuBLAS优化的矩阵乘法性能远高于通用einsum实现,我们可以将运算转换为矩阵乘法形式:
# 先把每个r对应的ij维度展平,shape从[σ, δ, δ]转为[σ, δ²]
A_flat = A.flatten(1)
B_flat = B.flatten(1)
C_flat = C.flatten(1)

# 矩阵乘法等价于原始的X、Y、Z计算
X = A_flat @ A_flat.T
Y = B_flat @ B_flat.T
Z = C_flat @ C_flat.T

# 逐元素相乘后求和,等价于最后一步einsum
res = (X * Y * Z).sum()
3. 利用对称特性进一步加速
因为X、Y、Z都是对称矩阵,原始求和中r≠s的项会被计算两次,我们可以只计算上三角部分再乘以2,计算量直接减少近一半,适合σ较大的场景:
A_flat = A.flatten(1)
B_flat = B.flatten(1)
C_flat = C.flatten(1)

# 计算对角线部分的和
diag_vec = (A_flat * B_flat * C_flat).sum(dim=1)
diag_sum = diag_vec.pow(3).sum()

# 计算上三角非对角线部分的和,乘以2对应r<s和s<r的两组对称项
cross_mat = (A_flat @ A_flat.T) * (B_flat @ B_flat.T) * (C_flat @ C_flat.T)
off_diag_sum = cross_mat.triu(1).sum() * 2

res = diag_sum + off_diag_sum
不同方案适用场景
- 如果追求代码简洁易读,选择合并einsum的方案即可
- 如果追求GPU上的极致性能,选择矩阵乘法实现的方案
- 如果σ远大于δ,可在矩阵乘法基础上增加对称优化进一步提速
内容的提问来源于stack exchange,提问作者wojas
相关产品推荐
相关产品推荐


