
小词汇集如何替代one-hot编码生成语义关联word embeddings

2026-9-2
小规模词汇集词嵌入落地实现方案
你手里只有33个名词、动词组成的小词表,直接从零训练Word2Vec/GloVe跑不通是正常的——这类词嵌入模型本质是靠词语在大量文本里的共现规律学语义,没有足够上下文语料根本训不出有效向量。下面是可直接落地的实现路径,完全能达到语义相近词向量空间距离更近的效果。
3种可直接落地的实现路径
- 路径1:加载开源预训练词向量直接查表(优先选,零训练成本、效果最稳)
不用自己写训练逻辑,直接用大厂在百亿级通用文本上训好的成熟词向量包,把你词表里33个词对应的向量摘出来就能用。这类预训练向量已经把通用语义关系学得很充分,比如father和mother、parent这类亲属词距离近,sing和dance、run这类动作词距离近,完全匹配你的需求。
操作步骤:- 选适配的预训练包即可,你词表里都是日常基础常用词,选谷歌新闻语料训的300维Word2Vec、或者斯坦福开源的6B规模GloVe向量都可以,不会出现词找不到的问题
- 用gensim加载模型、提取目标词向量,核心代码只有几行:
from gensim.models import KeyedVectors # 加载提前下载到本地的预训练模型文件 model = KeyedVectors.load_word2vec_format("GoogleNews-vectors-negative300.bin", binary=True) # 替换成你自己的33个词的词表 your_vocab = ["father", "sing", ...] # 直接提取所有词的嵌入向量 word_embeds = {word: model[word] for word in your_vocab}- 如果要做你示例里的二维聚类图,用TSNE把300维的高维向量降到2维,拿matplotlib散点图标注词就行,语义相近的词会自动聚成簇。
- 路径2:构造小规模自定义语料轻量训练(适合有特殊语义需求的场景)
如果你要的语义关系不是通用日常语义,是特定场景下的关联关系,可以自己构造适配的小语料训练:给每个词造几十句包含它、以及它的语义关联词的简单句子,总语料量凑到5000-10000句就够。
操作步骤:- 造语料时刻意让语义相近的词出现在相似上下文里,比如要让亲属词聚成一类、动作词聚成一类,就多写"He is my father" "She is my mother" "I can sing" "I can dance"这类句子
- 调小模型参数适配小语料,用gensim训练即可,参考代码:
from gensim.models import Word2Vec # sentences是分好词的语料列表,格式为[["he", "is", "my", "father"], ["i", "can", "sing"], ...] model = Word2Vec( sentences=sentences, vector_size=50, # 小语料不用设太高维度,50/100足够 window=3, min_count=1, epochs=30 ) word_embeds = {word: model.wv[word] for word in your_vocab} - 路径3:下游任务端到端训练嵌入层(适合接NLP任务的场景)
如果你做词嵌入是为了给后续文本分类、语义匹配这类任务做输入层,不用提前单独训Word2Vec,直接在深度学习模型的第一层加nn.Embedding(33, embed_dim),跟着下游任务的标注数据一起训练就行,训练完的第一层权重就是适配你任务语义的词嵌入,同类别/语义相近的词会自动学到更近的空间距离。
常见踩坑提醒
别拿着33个孤立的词直接喂给训练脚本:不管是gensim的Word2Vec还是原生GloVe,都必须输入分好词的句子序列当训练材料,只有光秃秃的词表没有任何上下文,模型学不到任何语义关联,这也是你之前尝试落地失败的核心原因。
效果参考示例: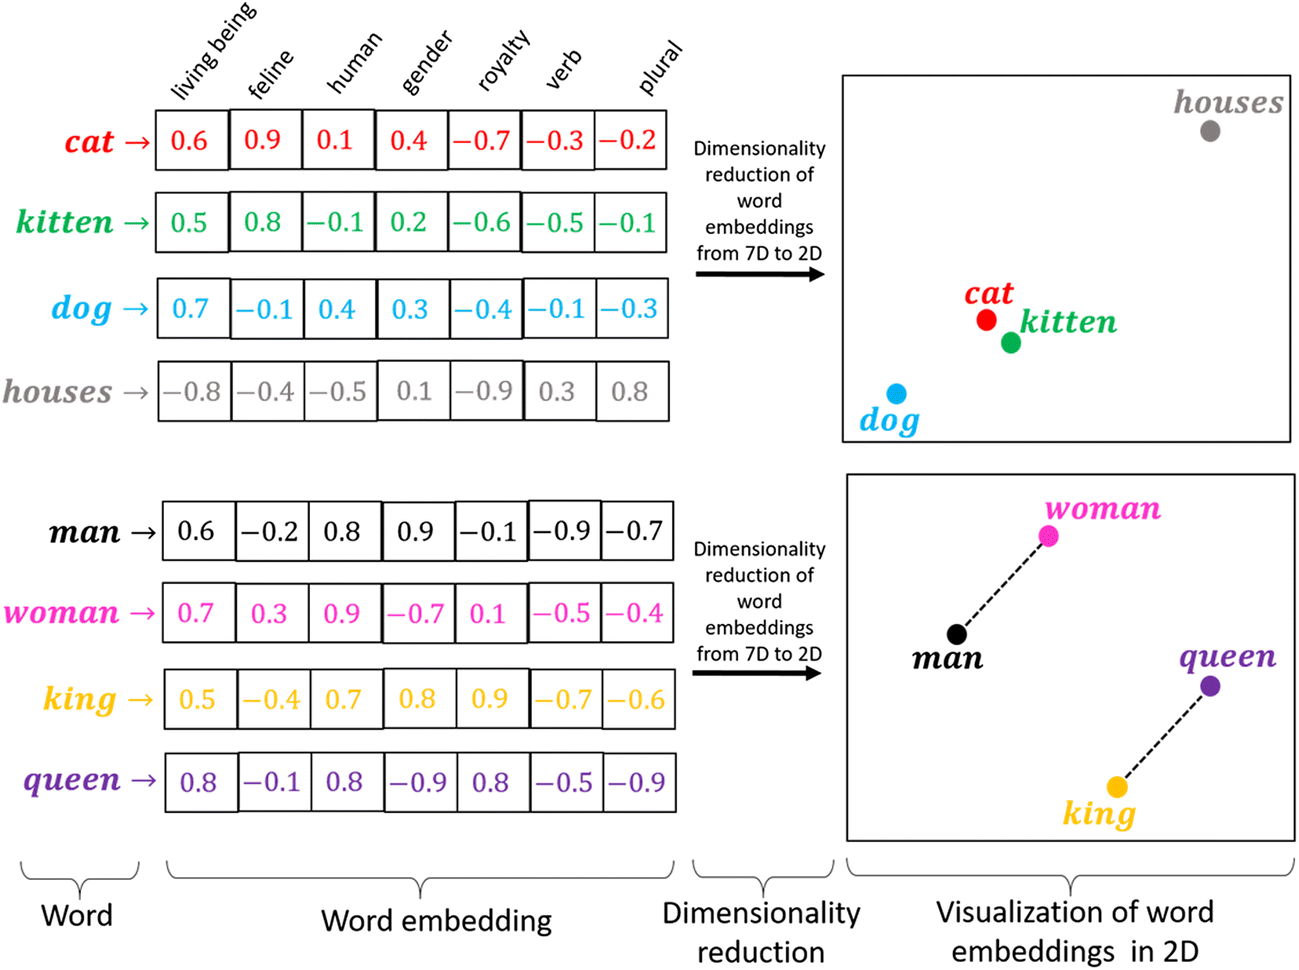
参考学习方向
- 先理解Word2Vec核心逻辑:不用死抠公式推导,重点搞懂「词的语义由它所处的上下文决定」这个核心假设,以及Skip-gram、CBOW两种训练模式的差异即可
- 熟悉gensim库的两个核心类:
KeyedVectors用来加载预训练向量、计算词相似度,Word2Vec用来从零训练自定义模型,把常用参数的含义摸清楚足够应付小数据集场景 - 掌握TSNE降维方法:用来把高维词向量映射到2维/3维空间,就能画出示例里的语义聚类散点图
内容的提问来源于stack exchange,提问作者sidgupta234
相关产品推荐
相关产品推荐


