
NumPy中意外计时差异的原因探究

2026-6-20
NumPy数组初始化性能测试疑问解答
近期针对NumPy中多种数组分配与初始化流程做了计时测试,测试数据为给定数据类型下数组元素数量n与执行时间的关系,图表如下: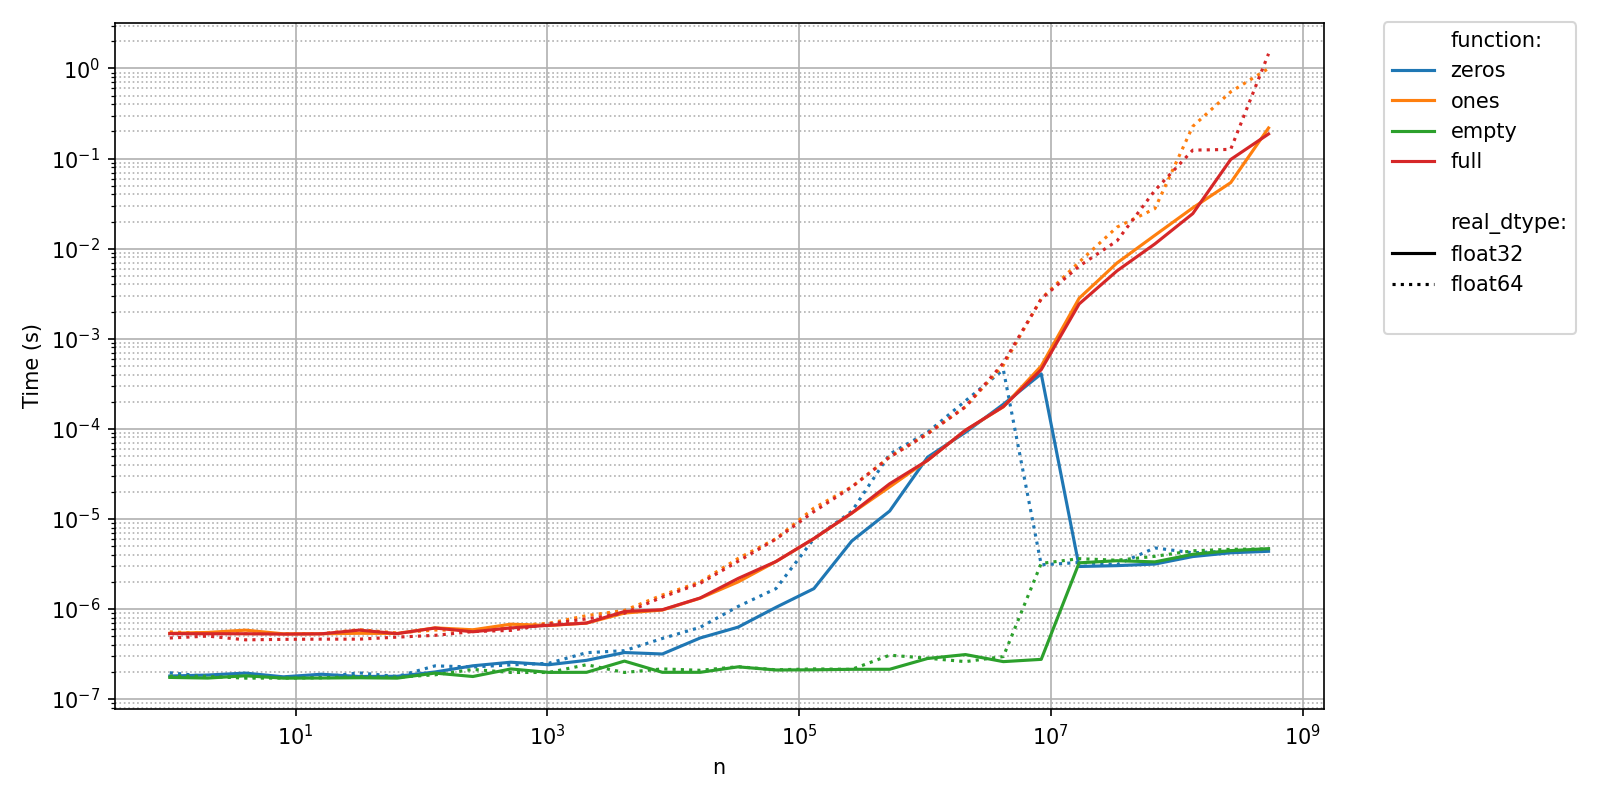
1. 为何np.ones与np.zeros的计时差异显著?
- 底层内存分配机制差异:
np.zeros可以直接利用操作系统的**零页(zero page)**机制——操作系统会预先分配已经清零的内存页,无需NumPy自行逐个元素赋值,这一步几乎无额外开销。而np.ones需要在内存分配完成后,对每个元素执行写入1的操作,这会产生实际的内存写入开销,耗时随数组规模线性增长。 - 硬件缓存优化:零页机制能避免缓存污染,因为零页通常由操作系统预加载;而
np.ones的写入操作会触发缓存行的填充与刷新,进一步拉大两者的时间差距。
2. 为何在数百万元素量级附近出现不连续现象?
- 内存层级切换:当数组规模超过CPU缓存(L1/L2/L3)的容量时,程序会从高速缓存切换到主内存存取数据。主内存的访问延迟远高于CPU缓存,导致执行时间出现跳变。以常用的float64类型为例,百万元素约占8MB,刚好触及多数CPU L3缓存的临界容量,超过后内存访问模式改变,时间曲线出现不连续。
- 操作系统内存分配策略:小内存块可从堆中快速分配,而大内存块需要触发更复杂的内存页调度或物理内存分配流程,这也是导致时间突变的原因之一。
内容的提问来源于stack exchange,提问作者G. Fougeron
相关产品推荐
相关产品推荐


